


La carrera por el desarrollo de la inteligencia artificial ha dado un giro inesperado que trasciende lo digital: las grandes compañías tecnológicas están adquiriendo masivamente libros de segunda mano, especialmente ejemplares de no ficción descatalogados, para alimentar sus modelos de lenguaje. Este proceso no busca la preservación, sino la obtención de datos humanos puros, libres de la "contaminación" generada por la propia IA en internet.

La estrategia detrás de la destrucción masiva
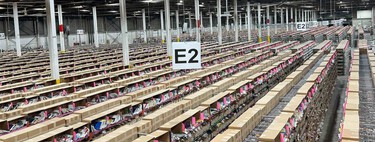
Libreros de todo el mundo han detectado un patrón inusual: compradores que adquieren miles de ejemplares sin importar el valor de mercado ni la coherencia temática. Empresas como ZoomBooks o plataformas como ISBNdb actúan como intermediarios, facilitando el acceso a estos textos a laboratorios de IA. La clave de esta operativa reside en una interpretación legal del fair use: para que la digitalización y el entrenamiento sean considerados un uso transformador legal, el ejemplar físico debe ser destruido tras su escaneo, evitando así la duplicidad de copias.

El valor del texto no contaminado
El auge de este mercado responde a la necesidad crítica de las empresas de IA de obtener material original, impreso antes de 2022, antes de que el volumen de contenido generado automáticamente inundara la red. Documentos internos, como los vinculados al llamado Project Panama de Anthropic, revelan que el objetivo es escanear sistemáticamente el conocimiento humano impreso. Mientras las compañías tecnológicas priorizan la confidencialidad en sus acuerdos, los sectores culturales denuncian esta práctica como un expolio literario que pone en riesgo el patrimonio bibliográfico local, desde fanzines hasta documentación histórica de movimientos sociales.

!Advertencia! Tenemos problemas...
Debes iniciar sesión para poder comentar.. Iniciar sesión o Registrarme